OposIA
Prepara tu oposición con tests generados desde el temario oficial.
Disponible el 99,93 % en 24 h · Actualizado el mes pasado · Historial
El problema
Preparar una oposición significa memorizar un temario oficial largo y practicar con tests que reproduzcan el examen real: mismo formato, misma penalización, mismo tiempo.
Los generadores genéricos de preguntas inventan contenido o mezclan fuentes. Aquí cada pregunta tiene que salir del temario de esa oposición concreta y poder rastrearse hasta el tema.
El enfoque
Un índice vectorial por oposición, construido desde el temario oficial página a página: cada fragmento sabe de qué documento y qué página viene.
Un modo por tarea — estudiar un tema, generar preguntas, simulacro, resumen, repaso o chat — cada uno con su prompt y con el número de fragmentos que necesita.
Dos filtros antes de responder: un umbral sobre la puntuación del reranker y un prompt que solo admite lo recuperado. Si no está en el temario, el asistente lo dice sin llamar al modelo.
Un banco de preguntas en PostgreSQL: cada pregunta generada se guarda con su tema, su página y sus estadísticas. Un cuestionario toma la mitad del banco (lo que esa persona no ha visto) y genera la otra mitad en segundo plano, por lotes de 10 que mezclan temas; se corrige en el servidor y la respuesta correcta nunca viaja al navegador antes de tiempo.
Arquitectura
Frontend React + Vite (páginas de estudio, preguntas, examen con temporizador, progreso, chat y panel) servido por nginx.
API FastAPI; ingesta con PyMuPDF (texto reconstruido por coordenadas, OCR con tesseract para páginas escaneadas) y LlamaIndex sobre ChromaDB (una colección por oposición).
Embeddings Cohere embed-multilingual-v3.0; reranking Cohere; LLM por cascada de cinco modelos en tres proveedores (Groq gpt-oss-120b y 20b, Mistral ministral-14b, Groq qwen3.8-27b, Gemini 3.6-flash) sobre APIs compatibles con OpenAI; Ollama en local.
PostgreSQL para oposiciones, banco de preguntas, exámenes, progreso y cuentas; Redis para sesiones. Docker, desplegado con Coolify tras Cloudflare. Dos tareas nocturnas por cron: rellenar el banco y juzgarlo.
Cuentas: enlace por correo (Resend), email y contraseña (bcrypt) o Google (ID token validado en el servidor). Sin cuenta la app funciona igual; al crearla, lo hecho como anónimo se fusiona en ella.
Decisiones que importaron
Chunks de 256 tokens con solapamiento de 30 en vez de 512: las preguntas tipo test necesitan fragmentos precisos, no párrafos largos.
Sobremuestreo ×8 en la búsqueda vectorial y reranking después: se recuperan muchos candidatos baratos y el reranker elige los 4–12 que van al modelo.
Embeddings de consulta con input_type search_query y de documento con search_document: Cohere los trata distinto y la calidad de recuperación mejora.
El índice del PDF completo del temario se excluye de la recuperación para que no eclipse a los temas individuales.
Historial acotado a los últimos 8 mensajes y contexto de 6.000 caracteres para vivir dentro de los 8.000 tokens/minuto del tier gratuito de Groq: el chat pasó de morir a la sexta pregunta a aguantar catorce seguidas, y la latencia mediana bajó de 4 s a 3 s.
Umbral sobre la puntuación del reranker medido en producción, no elegido a ojo: una pregunta ajena al temario puntúa 0,0005 y una débil pero pertinente 0,07, así que el corte va en 0,02 y el segundo filtro es el propio modelo (responde NO_KB si los fragmentos no tratan del asunto).
Lectura de PDF por coordenadas (PyMuPDF) en vez de texto plano: las tablas y columnas del temario llegaban mezcladas. Cada página es un documento con su número, y los fragmentos tienen ids deterministas: reingestar no duplica.
El modelo es una variable de entorno, no código: cuando Groq retiró llama-3.1-8b (septiembre de 2026), la migración fue un cambio de configuración. Qwen3-27B se descartó por su tope de 1.000 tokens de salida/minuto en el tier gratuito; gpt-oss-120b no lo tiene.
Los modelos gpt-oss razonan antes de contestar y ese razonamiento se descuenta de max_tokens: con 4.096, el JSON de 10 preguntas llegaba cortado en la mayoría de los lotes. Ahora se pide con 8.192 tokens y reasoning_effort=low, y de un JSON truncado se rescatan las preguntas completas en vez de tirar el lote.
Los fragmentos van numerados en el prompt y el modelo declara de cuál sale cada pregunta: el tema y la página son exactos, sin fiarse de lo que el modelo escribe. Y toda pregunta que remita al material («según el fragmento 3…») se descarta y se regenera, porque el opositor no ve el texto.
Búsqueda léxica además de la vectorial: las referencias normativas («art. 24», «Ley 39/2015») y las frases literales se buscan tal cual en el índice y se suman a los candidatos antes del reranker. La evaluación de recuperación pasó de 7/9 a 9/9.
Sin pagar inferencia: en vez de un modelo y un fallback, una cascada de cinco modelos gratuitos en tres proveedores. Un 429 pone al modelo en cuarentena y pasa al siguiente; un 404 lo retira; al arrancar y cada 24 horas se contrasta la lista con el catálogo del proveedor. Cuando Groq retiró dos modelos a la vez, no hubo que tocar nada. El banco se rellena de madrugada con los cupos del día, y de día las preguntas salen del banco al instante.
El tema lo da la carpeta, no el modelo: en Imagen para el Diagnóstico el temario venía en 30 carpetas numeradas («6. Abdomen y Vías Biliares»), así que cada fragmento lleva su carpeta y la cita dice «Tema 6 · 1. Abdomen.pdf, pág. 12». Los simulacros muestrean por tema con el mismo peso, no por fichero.
Un juez para el banco, no para cada respuesta: cada pregunta se evalúa una vez contra su fragmento fuente con seis criterios (fundamentada, clave correcta, una sola correcta, autocontenida, distractores plausibles, clara). Los tres primeros son fatales y retiran la pregunta. La nota es determinista (criterios cumplidos / 6): el modelo describe, no puntúa. Y como las opciones se barajan después, el juez razona sobre el texto de la opción, nunca sobre su letra.
La primera evaluación descubrió el fallo típico: preguntas que citaban leyes o artículos que no estaban en el fragmento. Se corrigió en el prompt de generación (solo lo que dice el texto; la respuesta debe poder confirmarse en él) y el siguiente lote bajó del 17 % al 9 % de inválidas. Tres avisos de usuarios distintos retiran una pregunta aunque el juez la diera por buena.
Identidad sin fricción: la app es usable de forma anónima (30 días en ese navegador) y la cuenta es opcional. Una cuenta es un email con una sesión canónica; al entrar desde otro dispositivo, lo hecho como anónimo se fusiona (progreso sumado por tema, exámenes movidos, preguntas vistas sin duplicar) y nunca se adopta una sesión que ya es de otra persona. Los tokens del enlace por correo se guardan hasheados y sirven una vez.
Resultados
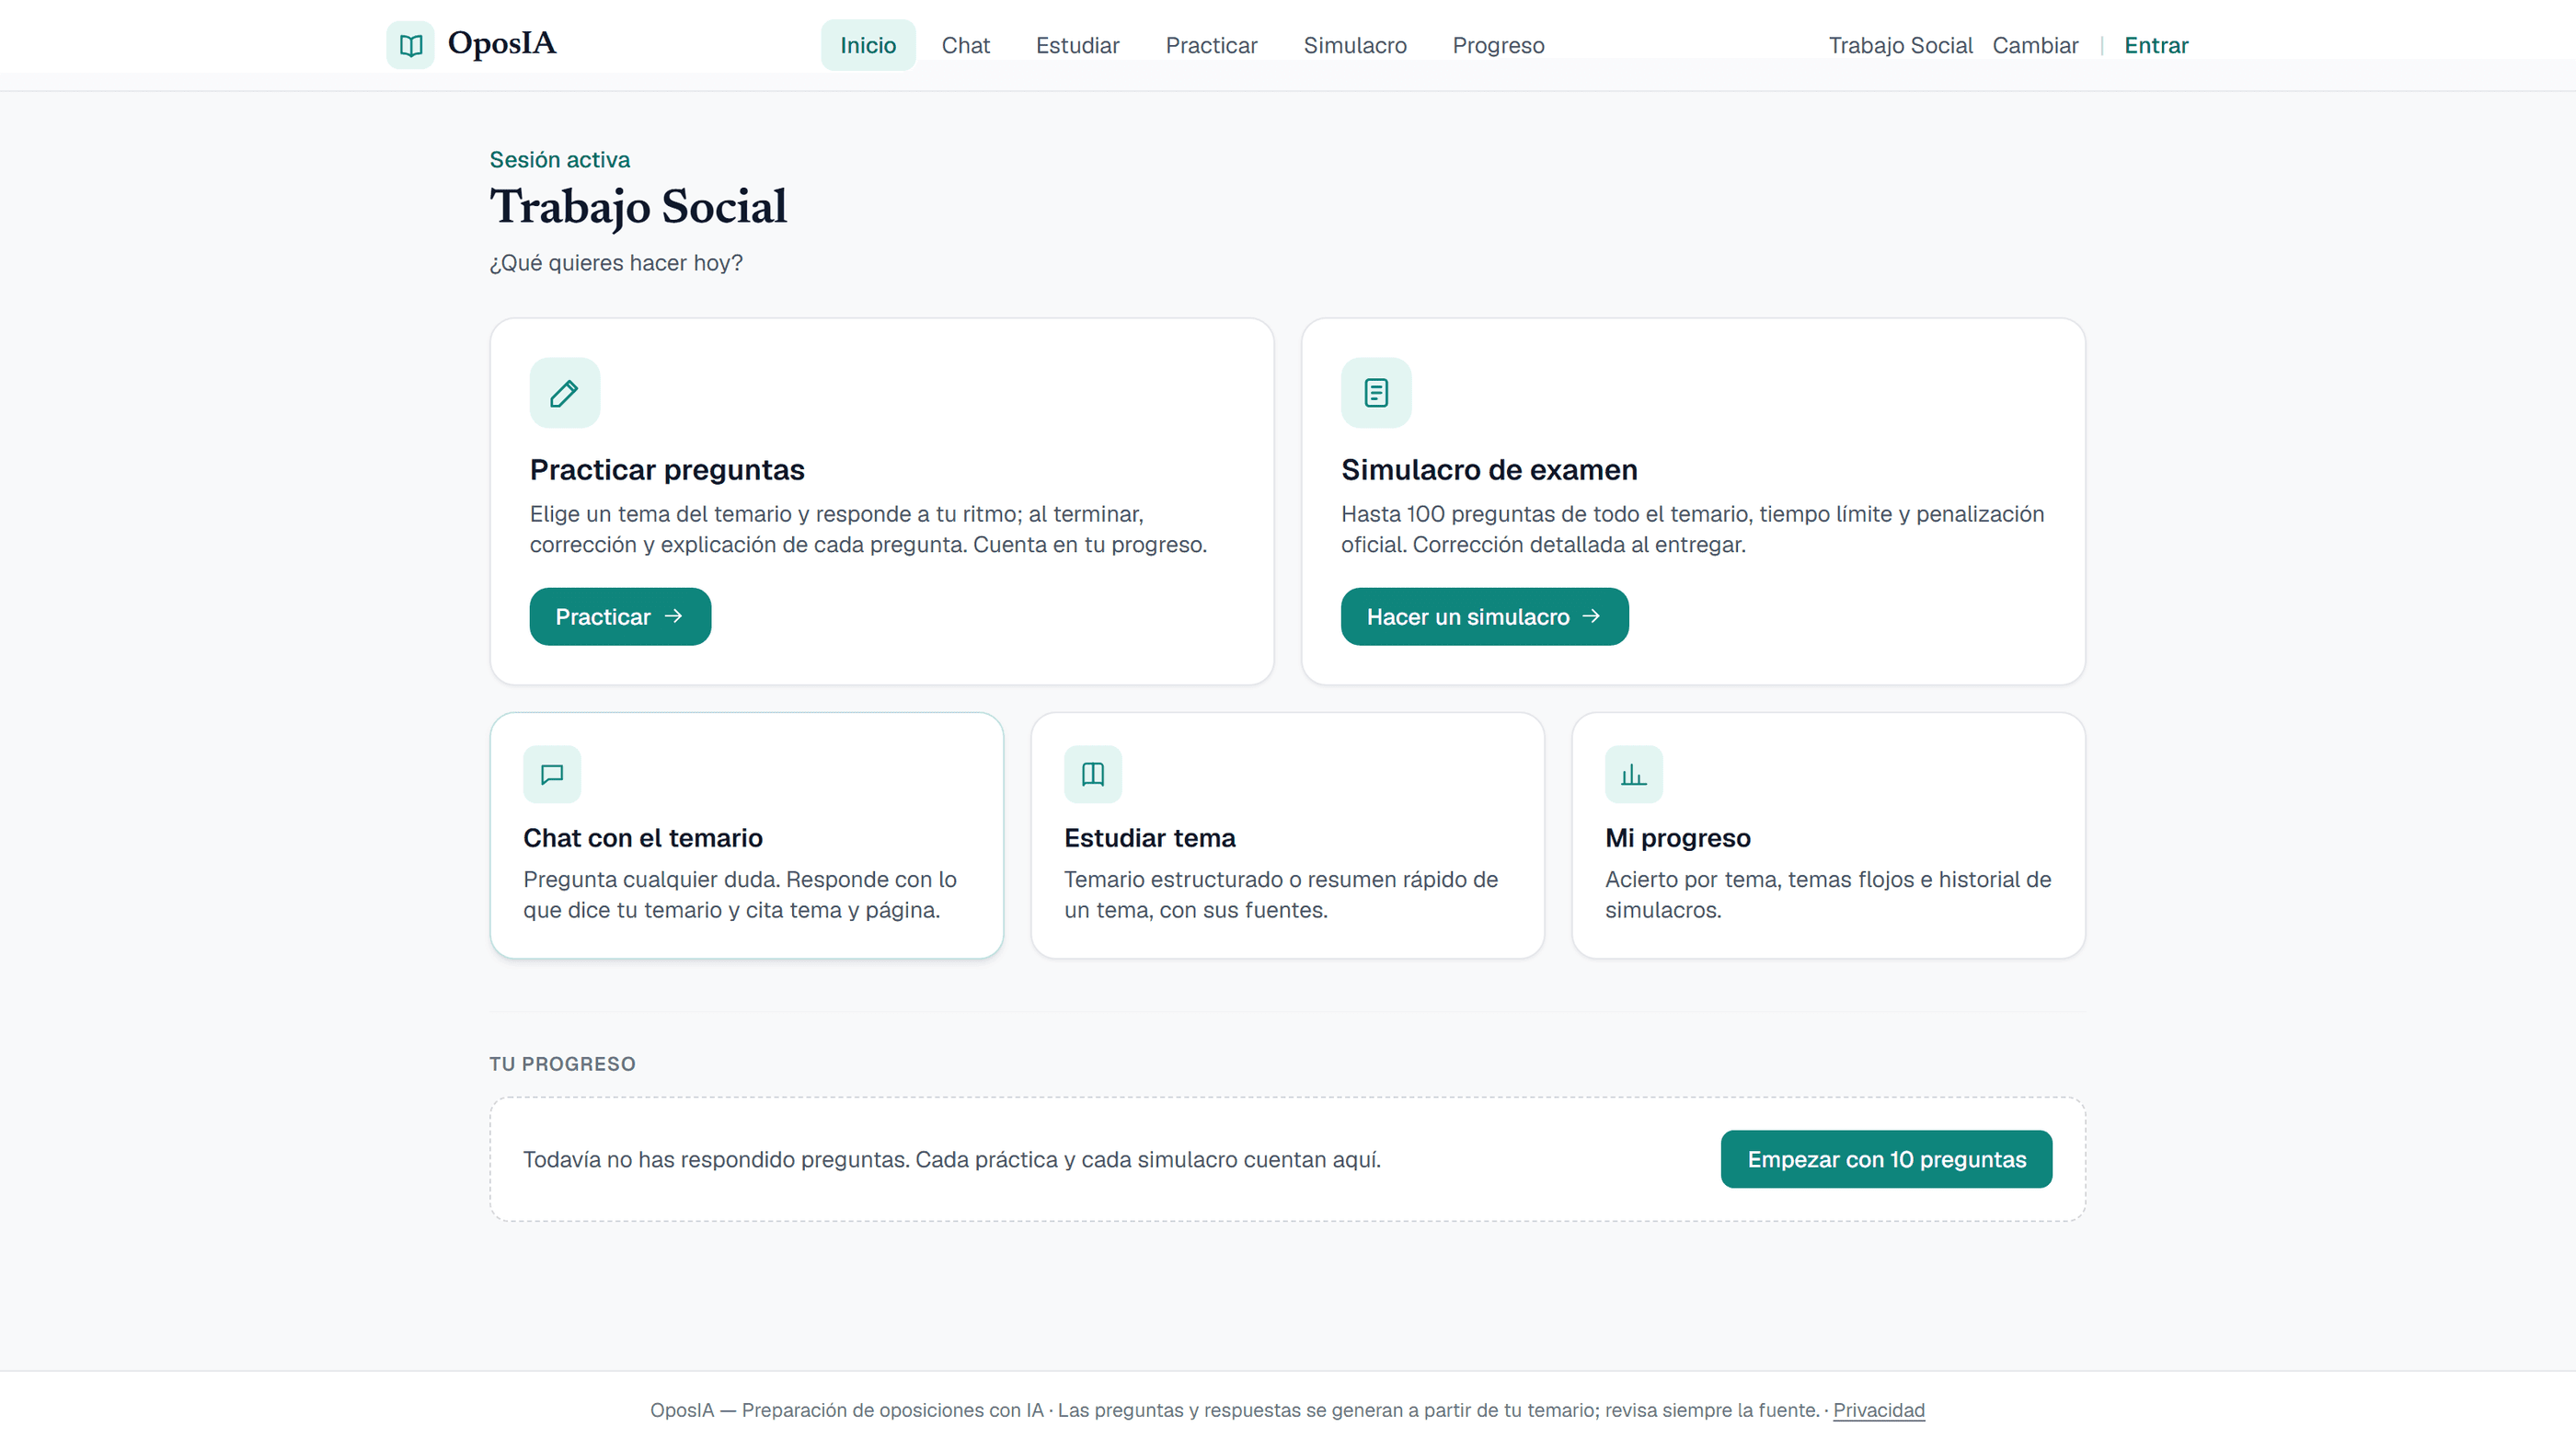
En producción en oposiciones.iana-ai.com con dos oposiciones: Trabajo Social (41 documentos, 27 temas, 4.550 fragmentos) e Imagen para el Diagnóstico (57 documentos, 30 temas, 3.297 fragmentos). Cada fragmento sabe su tema, su fichero y su página.
Banco de 2.677 preguntas (22-09-2026) generado de madrugada con cupos gratuitos. Juzgadas 1.160 contra su fragmento fuente: 84 % válidas; las otras se retiran antes de que nadie las vea. Por modelo generador, gpt-oss-120b acierta el 94 %, ministral-14b y gpt-oss-20b entre el 75 % y el 87 %.
Chat con citas en las dos oposiciones: 6 de 6 preguntas de control citan tema y página; mediana 2,9 s. Evaluación de recuperación de Trabajo Social: 9 de 9, y la pregunta ajena al temario recibe la respuesta fija sin llamar al modelo.
Práctica de 10 preguntas: 8 llegan del banco al instante y las 10 están listas en 2,4–4,5 s. Simulacro de 100 con el formato real (penalización 1/3, corte 5): 50 al instante y el resto mientras se contesta.
Coste de inferencia: 0 €/mes. Groq retiró dos modelos en julio y la cascada siguió sola.
Lighthouse móvil de la portada: rendimiento 93, accesibilidad 100, buenas prácticas 100, SEO 100. CSP, caché inmutable de assets, HSTS y proxy de Cloudflare.
Cuentas con enlace por correo, contraseña o Google; política de privacidad y borrado de cuenta desde la app.
Siguiente
- Identidad visual propia: paleta, tipografía e iconos en lugar de los emojis del sistema
- Tercera oposición (Gestor de Administración) en cuanto haya temario
- Vaciar la cola del juez (150 preguntas por noche) y publicar la tasa de válidas por modelo de forma continua
- Capacidad para uso real: la cascada gratuita suma unos 400.000 tokens/día en Groq más Mistral y Gemini; con decenas de opositores activos tocará tier de pago