MasterScroll
Crea tu personaje de D&D 5.5e con un asistente que conoce los manuales.
Disponible el 99,79 % en 24 h · Actualizado el mes pasado · Historial
El problema
Crear un personaje de D&D 5.5e implica cruzar cientos de páginas de manuales: razas, clases, trasfondos, dotes y reglas que cambian entre ediciones.
Los asistentes genéricos mezclan ediciones o inventan rasgos. El objetivo era un asistente que construya la ficha justificando cada elección con el manual.
El enfoque
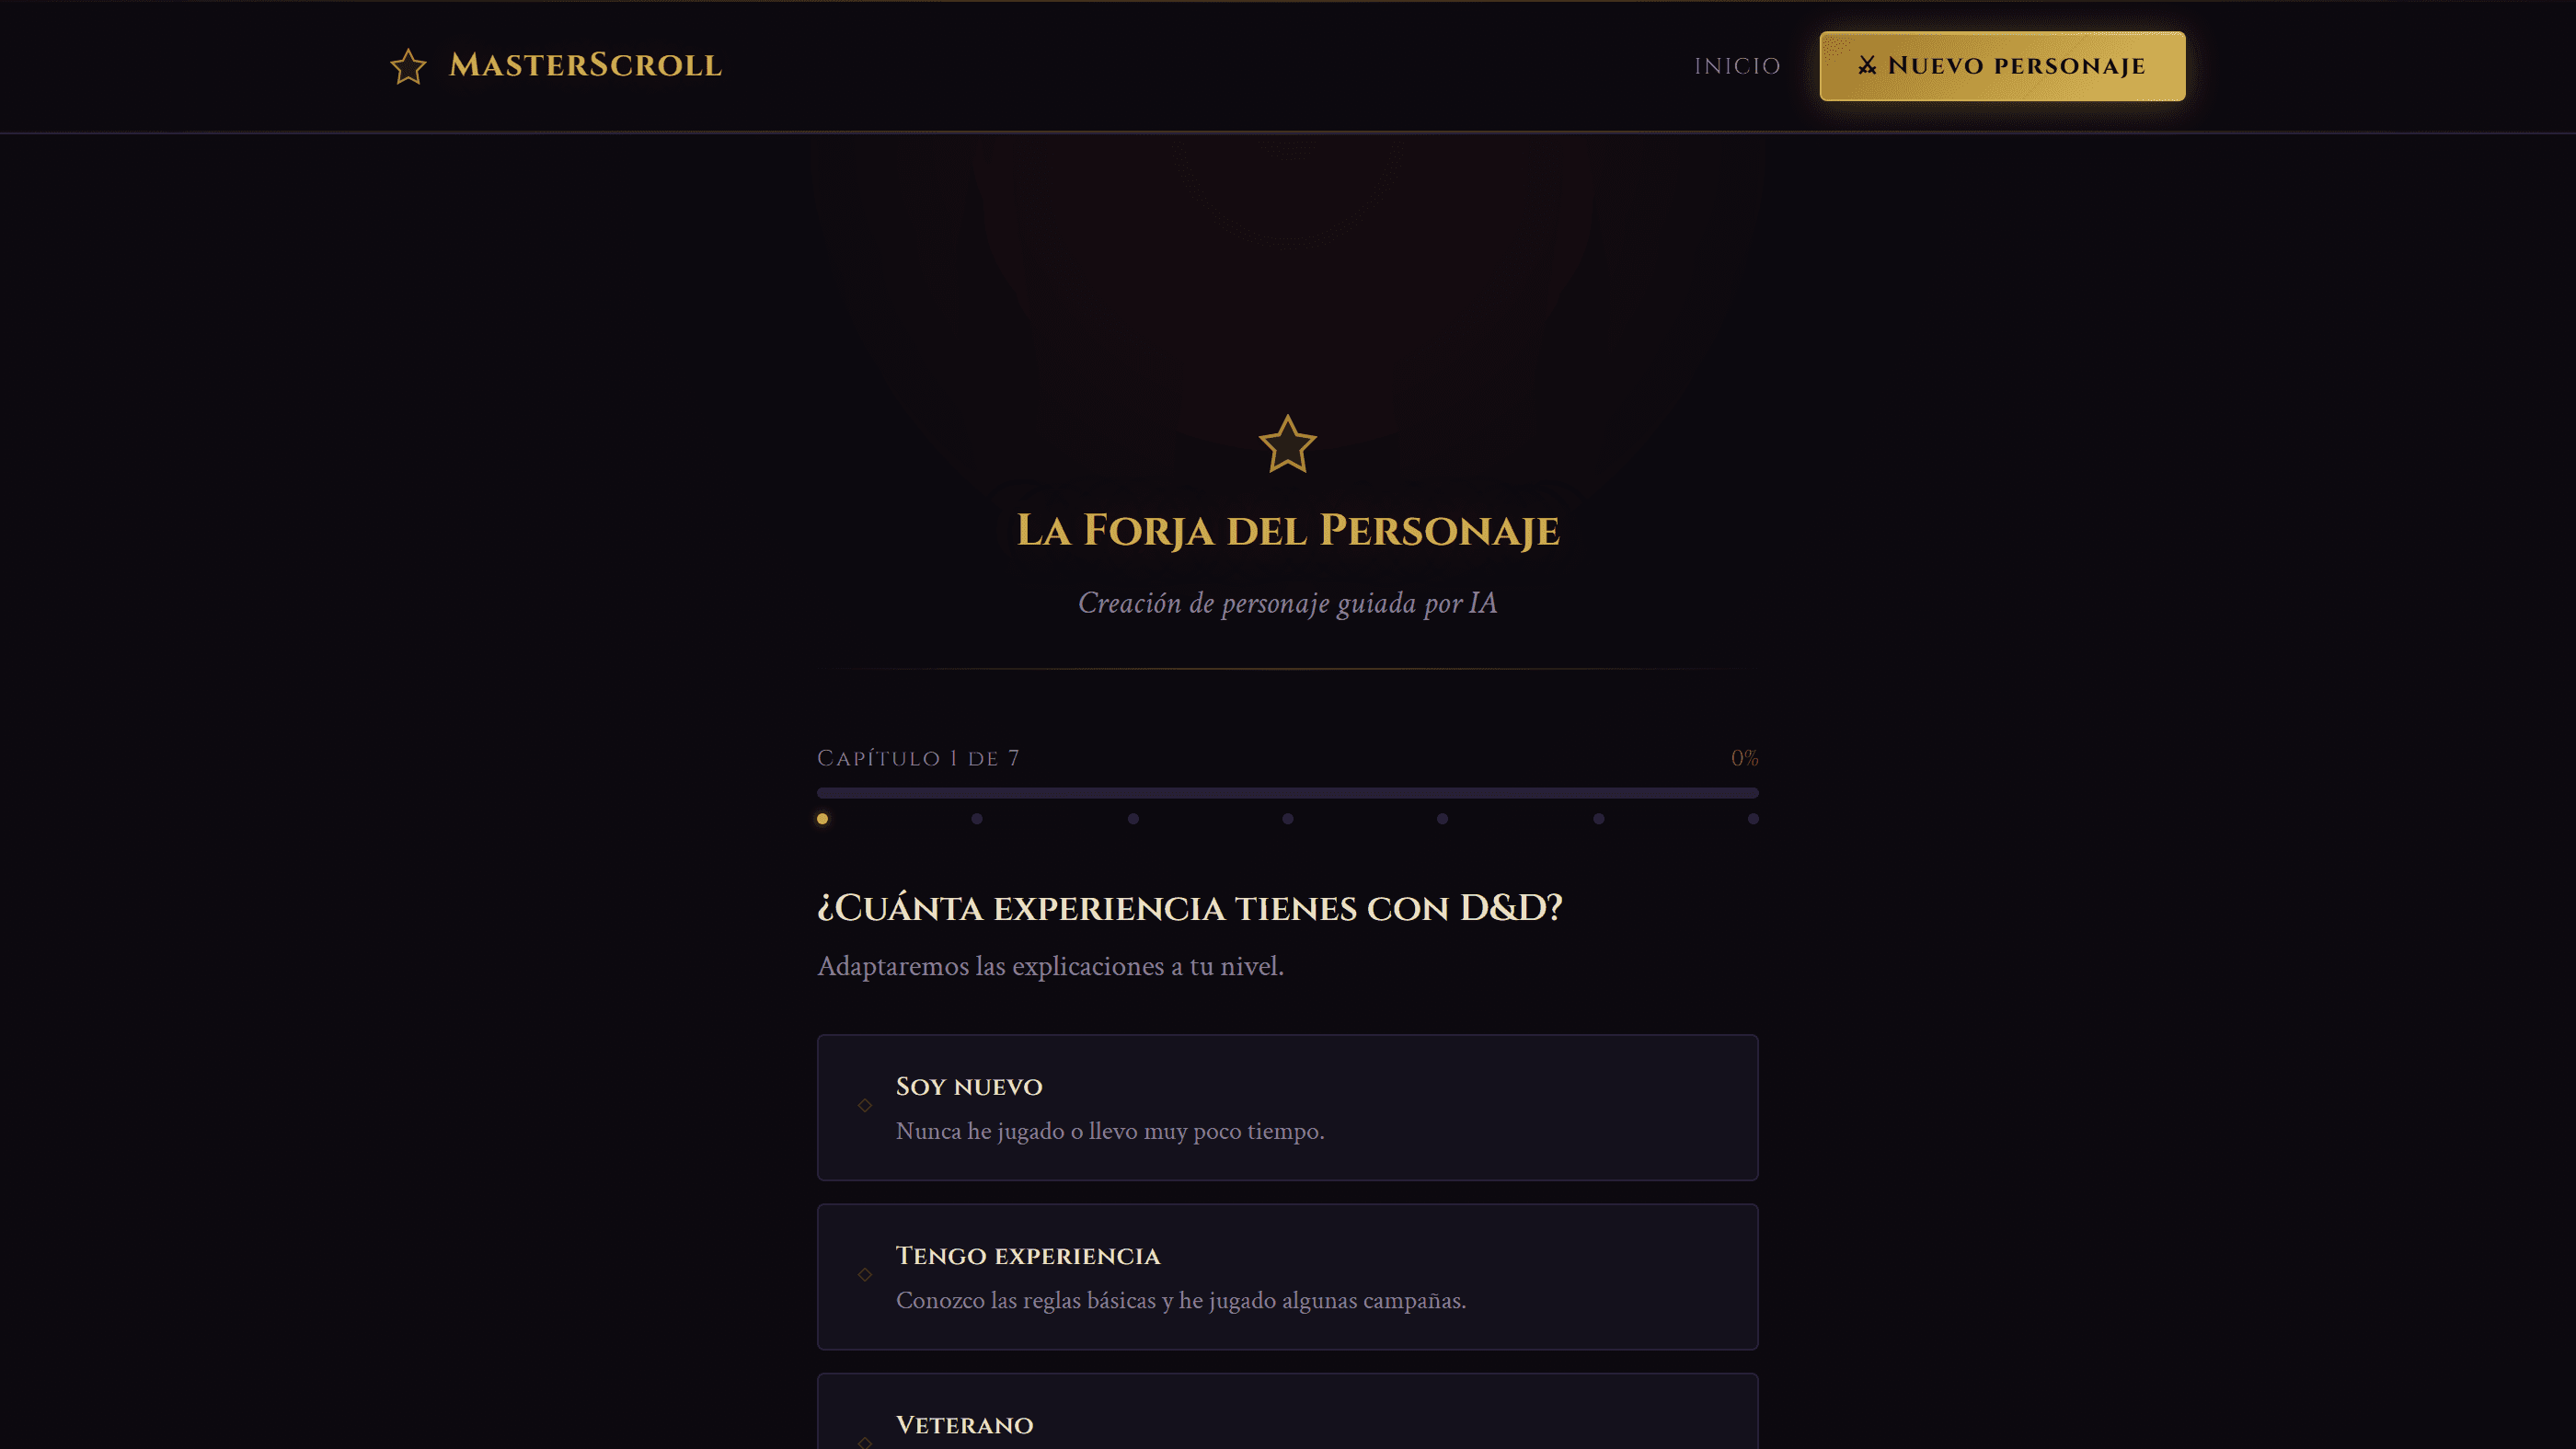
Flujo en tres fases orquestado con LangGraph: onboarding (hasta 7 preguntas sobre concepto y estilo), borrador (RAG sobre los manuales + LLM) y refinamiento iterativo por chat.
Búsqueda web opcional con Tavily para contenido de comunidad, separada de la recuperación sobre los manuales.
Ficha final interactiva y exportable a PDF.
Arquitectura
Frontend React + Vite + Tailwind; backend FastAPI con streaming SSE.
RAG con LlamaIndex sobre ChromaDB; ingesta con PyMuPDF por coordenadas y OCR tesseract para manuales escaneados; embeddings Cohere embed-multilingual-v3.0 en producción (nomic-embed-text con Ollama en local); reranking Cohere.
LLM intercambiable: Ollama llama3.1:8b en local o Groq (gpt-oss-120b) en la nube, tras una interfaz común.
PostgreSQL para fichas y sesiones, Redis para caché de sesión y streaming, WeasyPrint para el PDF. Ingesta desde PDFs locales o desde Google Drive sin tocar disco.
Decisiones que importaron
Los manuales no van en el repositorio (derechos de autor): la ingesta acepta una carpeta de Google Drive vía cuenta de servicio y procesa los PDFs en memoria.
El proveedor y el modelo de LLM se eligen por variable de entorno: desarrollo gratis en local con Ollama, producción en Groq. Cuando Groq retiró llama-3.1-8b (septiembre de 2026), pasar a gpt-oss-120b fue un cambio de configuración (Qwen3-27B se descartó por su tope de 1.000 tokens de salida/minuto).
Reranking después de la búsqueda vectorial: la recuperación por similitud sola traía rasgos de la clase equivocada.
Sin fragmentos relevantes el asistente responde igual (es un asistente de juego, no un temario), pero avisa de que no lo ha verificado en el manual y no cita fuentes: el umbral del reranker solo filtra qué se cita.
Un manual escaneado entero (sin capa de texto) entra por OCR en CPU a unos 20 s por página; se acepta porque la ingesta es puntual y el índice persiste en un volumen.
Resultados
En producción en masterscroll.iana-ai.com. Siete manuales indexados: 5.001 fragmentos con página (uno de ellos, escaneado, por OCR).
Medido el 15-09-2026 con 10 preguntas de reglas (gpt-oss-120b): chat p50 2,6 s, p95 13,3 s; 10 de 10 respuestas citan manual y página.
Flujo completo: de siete preguntas a una ficha en PDF.
Siguiente
- Evaluación de la fidelidad de las reglas citadas
- Gestión de campañas y varios personajes